公車司機的 10 分鐘
2025 年暑假,一位陽明交大的碩士生鄭義穎到光華巴士當了兩個月的公車司機,開的是中山幹線。在《未來城市》的報導裡記錄了他的班表,6:50 發第一班車,一趟開了將近三個小時,9:50 才回到站,然後 10:00 又要再發車。中間這 10 分鐘,他說「幾乎只能跑步去上廁所」。他原本主張慢慢開、安全第一,開了幾週之後,自己也開始搶黃燈,因為慢慢開會脫班,也會吃掉自己的休息時間。
我覺得這件事很酷,一個做研究的人直接坐上駕駛座開了 60 天,等於用自己的身體跑了一場 hackathon。不過一個人能開的就是一條路線、兩個月,我更想知道這是中山幹線的狀況,還是其它路線也差不多?哪些時段最吃緊?這篇文章要介紹的「折返點」這個工具網站就是想回答這幾個問題。
為什麼是折返點?
這個專案的起點是市政 debug 松的第 5 題「公車路網如何即時反應需求」,題目最後有寫到:
把駕駛長過勞納入考量,例如盤點折返點的休息與大車暫停空間,把休息時間排進班表。
這裡的駕駛長就是公車司機。我把這個加分題當成主題來做,另外我也希望這不是一個小玩具而已,如果真的對市政有幫助,這可能還得會長期維護、繼續使用,不能只是一張好看或很炫的地圖而已。
命題也寫著各站上下車的刷卡人次沒有開放,可以用模擬資料。不過市府的公車即時資料裡就有車上人數,前後站相減就是每一站淨上下車的人數,所以這個專案沒有用到模擬資料。
台北的公車缺司機,缺額的數字依來源跟時間點不同,大概在 12% 到將近三成之間。2023 到 2026 年,台北市對 288 條公車路線中的 147 條做了調整,其中 80 條調降了離峰的服務水準(自由時報)。減班已經在發生了,只是依據比較像是「哪裡人不夠就減哪裡」,而不是算出哪裡最該減。
研究了一下才發現原來相關的規則其實早就有了,臺北市的《聯營公車申請分配調整路線及車次處理原則》寫著,跟捷運重疊 70% 以上,或是部分路段尖峰時段每班次上下車不到 5 個人的路線,可以列為裁撤或縮短的對象。根據聯合報的整理,《汽車運輸業管理規則》第 19 條之 2 規定駕駛連續開車 4 小時至少要休息 30 分鐘,分次休息的話每次不能少於 15 分鐘。
門檻都有了,但我找不到有人持續、公開、一條一條路線去量這些數字,例如折返點實際能停幾分鐘,以及跟捷運重疊的那一段實際載了多少人。
市府的資料只有「現在」
臺北市公共運輸處(公運處)有開放公車的即時資料,到站、離站、車上人數、GPS 位置都有,不需要申請就能下載。但這份資料是設計給「我的公車還有幾分鐘到」這類型的 App 用的,每台車只保留最新的一筆,新的一進來,舊的就被蓋掉,公運處也沒有開放歷史資料。所以像「上個月中山幹線的車在末站平均停了幾分鐘」這種問題,光靠公開資料是答不出來的。資料每幾秒就更新一次,只是沒有一個公開的地方把它存下來。
所以我寫了一個叫做 n-gear 的套件來採集資料,N 檔就是空檔,班表裡的空檔,就是司機能休息的時間。
n-gear 每 10 秒抓一次
n-gear 只做一件事,就是定時把三份即時資料抓下來並且去掉重複的,然後存成一行一筆 JSON 的 JSONL 檔案。n-gear 本身不做分析,也不畫圖。只要執行這個程式就會開始採集資料:
$ ngear collect --dir data
每抓一輪會印出一行摘要,這是實際跑出來的結果:
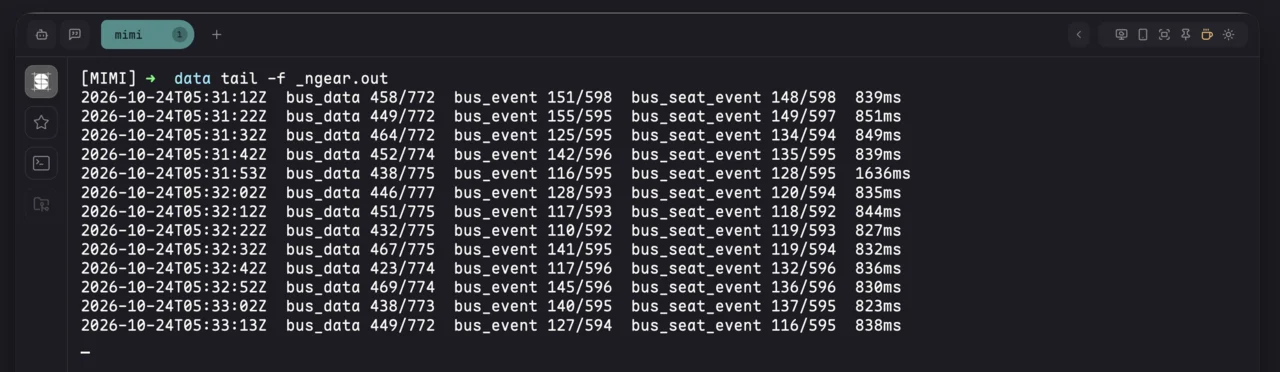
bus_data 是 GPS、bus_event 是到站跟離站、bus_seat_event 是車上人數,斜線前面是這一輪新寫進去的筆數,後面是資料裡全部的筆數。第一行是從空的目錄開始跑,所以每一筆都是新的。第二行是兩秒後另一個 process 再抓一次,只寫入這兩秒內真的有變化的部分。
為什麼是 10 秒?我實際測過,如果相隔 55 秒抓兩次的話,兩次都有出現的 1,072 台車裡,有 505 台已經換到別的站,甚至有車直接從某一站跳到下下站,中間那一站的到站跟離站紀錄就這樣不見了,事後也補不回來。
我另外用這幾天的抓取紀錄算了一下公運處的資料多久更新一次,到離站跟 GPS 大約每 5 秒,車上人數則是每 10 秒。10 秒是在「跟得上到站離站」跟「不要給公運處的主機太多負擔」之間取的平衡。實際漏了多少?以中山幹線 2026-10-19 這一天來說,完整的趟次該經過的 5,643 站裡,有 35 站沒抓到任何紀錄,大約 0.6%。
幾個實作上的細節:
每次請求都帶上一次拿到的 ETag,資料沒更新的話伺服器會回 304,就不用重新下載。
用車牌跟資料時間當 key,在記憶體裡放一個 30 分鐘的滑動視窗去掉重複的資料。程式重新啟動的時候,會先把最近的檔案讀回來,避免把同樣的資料再寫一次。
每小時把兩小時前的檔案壓成
.jsonl.gz,壓縮比大約 10 到 12 倍。壓縮的時候先寫暫存檔再改名,不管斷在哪一步都可以重跑。每天早上 4:30 把路線、站牌、班表這些靜態資料也存一份,順便記下 sha256,比對一下就知道路線或班表是哪一天改的。
為什麼不直接寫在「折返點」的專案裡?因為 n-gear 是整個系統裡唯一有時間壓力的程式,網站每部署一次就會重新啟動,如果採集也跟著重開,那幾秒的資料就沒了。n-gear 我再修正幾個功能後會開源,研究生或其他團體就可以直接拿去收同一份資料,做他們自己的題目。
我目前讓 n-gear 在跑在一台不會睡覺的 Mac mini 上,從 2026-10-18 下午開始收,到 10-24 早上為止,抓取沒有失敗過,兩次抓取之間最長隔了 15 秒,一個平日就有一千多萬筆紀錄。
收下來之後
原始檔案不進資料庫,分析是用 DuckDB 直接讀這些壓縮過的 JSONL,例如:
select count(*) from read_json_auto('data/bus_seat_event/*/*.jsonl*');
一天光是 GPS 就將近 700 萬筆,就這種整批掃描的工作來說,交給 DuckDB 會比 PostgreSQL 快很多,也不用先把檔案匯入資料庫。算好的結果,像是每一趟車、每一次停留之類的資料再寫進 PostgreSQL,網站最後再來讀這些算好的資料表。
網站不是即時的,資料至少會晚一天,而且目前還是我在自己的電腦上算好,再推到網站上。要調整的是班表跟路線,這些是以月為單位在決定的,需要的是夠多天、可以核對的數字。
SDD 開發
我不是交通專業,只是想透過寫程式來改善人類生活。這個專案是用 AI 搭配 SDD(Spec-Driven Development,規格驅動開發)的方式開發的,規格用我自己開發的 Spectra 來管理。
每個指標在寫程式之前要先寫成規格,像是什麼叫「一趟」、什麼叫「折返停留」、漏了起站或末站的那一趟要怎麼處理,每一條需求都要附上「在什麼情況下,應該得到什麼結果」的情境。到目前為止有 18 份規格、92 條需求、289 個情境。分析用的 SQL 是拿合成的資料來測試,預期的結果是照著規格手算出來的。
另外還有一份詞彙表,把「折返點」「週期」「漏站」這些詞的定義、特殊情況怎麼算、不要用的說法寫下來,文件、網頁文案跟程式都照著這份詞彙表。例如講到路線的兩端,網頁上用「末站」「折返點」,不用「終點」,因為有人會把終點理解成路線最遠的那一端,而在這幾條路線上,那一端剛好就是車子不停的地方。
從中山幹線看到什麼?
網站目前有三條路線,中山幹線、251 跟 251 區間車。以下是中山幹線「最近 7 天」頁面上的數字,涵蓋 2026-10-19 到 10-22 這四個平日。剛好接下來的 10-23、10-24 這兩天碰上薔琵颱風,公運處兩天都公告公車減班停駛(連黑客松的第二天也因為颱風改成全程線上)。10-23 早上 8 點,資料裡的車只有前一天的三分之一左右,這兩天的資料沒辦法拿來算,所以只有颱風前的這四天:
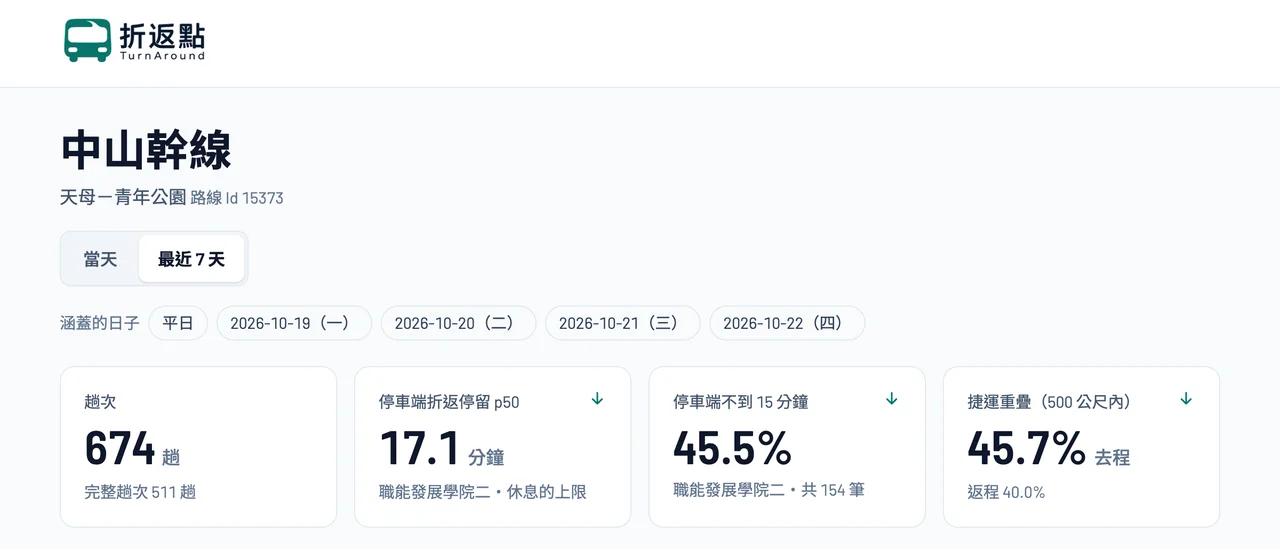
中山幹線一趟來回,只有一個地方能停。在青年公園那一端,車到了就直接開下一趟,四天量到 283 次,中位數是 1.9 分鐘。真正能停下來的只有天母那一端的職能發展學院二,那邊的 154 次停留裡,有 45.5% 不到 15 分鐘。
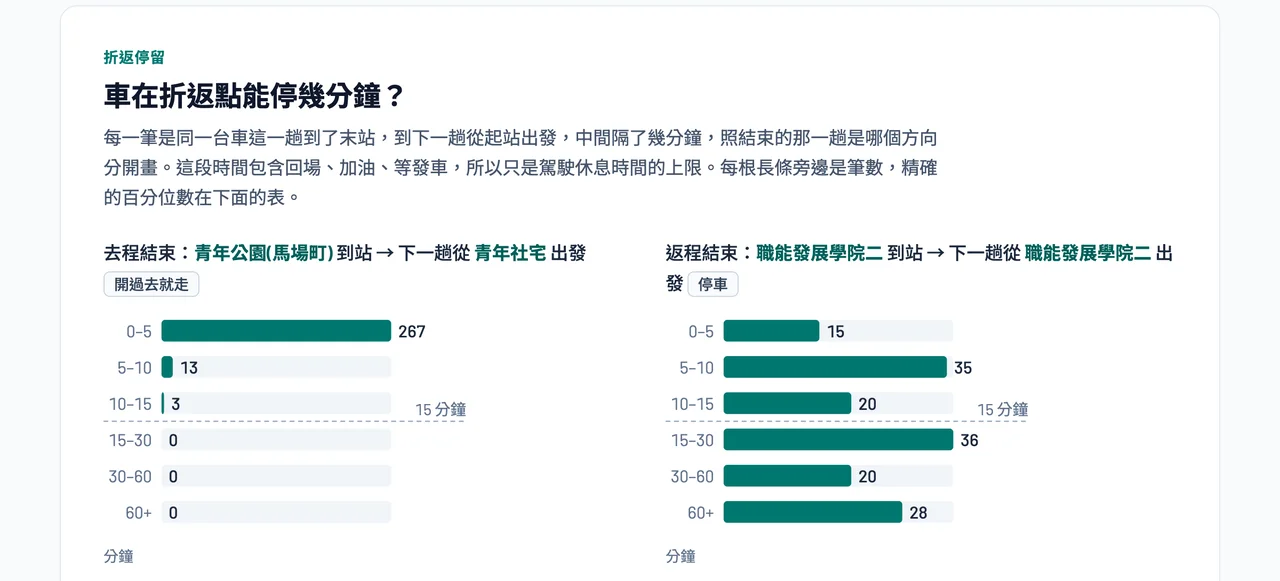
這 154 次如果照車子回到站的時間拆開來看,差別就出來了。下面這張表是我另外算的,頁面上還沒有(08 點指 8:00 到 8:59,其它以此類推):
| 回到站的時間 | 次數 | 中位數(分鐘) | 不到 15 分鐘 |
|---|---|---|---|
| 08 點 | 8 | 8.4 | 75% |
| 12 點 | 14 | 129.3 | 7% |
| 17 點 | 9 | 9.8 | 89% |
| 19 點 | 11 | 7.3 | 91% |
| 20 點 | 15 | 13.2 | 53% |
早上 8 點、傍晚 5 點到晚上 10 點前回到站的 61 次裡,有 41 次停不到 15 分鐘,其它時段的 93 次裡則是 29 次。中午回來的車反而會停一兩個小時,但這不代表司機在休息,可能是離峰收車、換班或回場,資料看不出來。所以要補的,是這幾個時段回到站的那幾趟。
補起來要花多少?網站上有一個「換休息試算」。如果只把不到 15 分鐘的停留補到 15 分鐘,中山幹線一天要多 2.0 個車時(一台車跑一小時算一個車時),最忙的那個小時要多 0.3 台車。如果每一次都多留 15 分鐘,就是一天 9.6 個車時,最忙的時候多 0.9 台。目前這條路線一天平均用到 34 台車。
同樣的算法放到 251 上就很不一樣,251 停車的那一端,有 98.3% 的停留在 15 分鐘以上。
可以怎麼做?
以下是從這四天的數字看得出來的建議,樣本還不多,每個時段只有 3 到 15 筆:
如果你是調度站長,也許可以先把早上 8 點跟晚上這幾個時段回到站的車補起來。頁面上有每個發車時段的行駛時間中位數跟 p85(85% 的車在這個時間內跑完),可以直接拿來排那幾趟的時間。
業者跟公運處要決定的,是要不要在晚上這幾個小時多排零點幾台車的班。要多排的其實是司機,車時要換成司機的工時,得有業者的勤務資料才算得出來。
青年公園那一端,直線距離 103 公尺就有公廁,但車子不在那裡停。如果能在那裡排個幾分鐘,等於一趟來回多一次上廁所的機會。大車能不能在那裡停,公開資料裡沒有,得去現場看看。
中山幹線的站牌離捷運出入口 500 公尺內的,去程佔 45.7%、返程佔 40.0%,沒有到 70% 的門檻(這是用我自己的算法,官方的算法沒有公開),重疊的那一段白天車上也還有十幾個人。
誰會用?
業者的調度站長,排班的時候看每個時段實際要跑多久、回到站能停多久。
司機本人,在折返點那幾分鐘用手機打開自己的路線,跟站長講話的時候手上有數字。
做排班研究的人。照報導的說法,鄭義穎的論文是用整數規劃把班距、人數、工時、休息放進同一個模型,這種模型需要知道每個時段實際要跑多久,網站上的行駛時間就是這個。
公運處、工會、議員或記者,查某條路線的停留、重疊跟載客,每個數字旁邊都有定義跟資料來源。
網站本身不會讓任何人多休息一分鐘,要等有人做了決定才有用。如果資料被拿去單純減班,那就是用錯地方了。
做不到的事
這個網站量得到的東西有它的限制,每一頁最後面也都有寫:
車不等於人。資料只認得車牌,認不出是哪一位司機在開。停留的時間包含回場、加油、等發車,只能當作休息時間的上限,而且雙班制下,一台車一天會由兩班司機輪流開。
車上人數是從票證資料推算的,準不準要看乘客下車有沒有刷卡,而且一趟跑完人數也不會歸零。
就算 10 秒抓一次還是有機會漏資料。
颱風假不在行政院人事行政總處的辦公日曆裡。像 10-23 那天停班停課,如果放上網站,會被當成一般的平日來算,所以颱風那兩天我都沒有放上去。
有些資料公開資料裡沒有。刷卡的起訖資料(從哪一站上車、在哪一站下車)在公運處跟票證公司手上,司機的勤務資料在業者手上,折返點的場站清冊則是到現在都還沒有人整理。有了這些,很多現在只能估的數字就能算準。
時間跟資料都有限,現在只做了三條路線、四個平日,沒辦法做到全部的路線。採集是整個路網都在收,但每一條路線都要先用它自己的資料確認算法沒問題,再人工查證兩端是怎麼折返的,才會放上網站。
小結
網站在 bus.5xcamp.us,目前只有三條路線,n-gear 也才收了一週左右的資料。採集一直在跑,路線會一條一條加上去。陽明交大的鄭同學在中山幹線身體力行得到的資訊,我希望之後每一條路線都能在網站上查得到 :)